视频去水印去字幕是常见的视频处理手段,剪辑师通常采用高斯模糊的手段将其模糊掉,虽然达成了让水印或者字幕不可被识别的目的,但视频画面明显被破坏。通用视频修复技术的发展,让无痕消除视频中的水印和字幕成为可能。本文回顾三种主流的视频修复模型,并详细介绍:以 E²FGVI 为基础,设计一个推理时无需输入或显式预测 Mask 的,消除效果好、推理速度快的视频去水印去字幕模型。
AI视频去水印去字幕,不模糊画面
视频里的一行字幕或一个水印,往往只占很小的面积。真正移除它时,问题却没有看上去那么简单:文字覆盖了原有像素,镜头和人物还在不断运动。如果逐帧处理,某一帧看起来干净的结果,连起来可能出现闪烁、模糊或边缘残留。通用视频修复模型为这类问题提供了基础。在去除视频里的水印与字幕场景中,如何智能定位水印与字幕区域、减少人工干预,以及如何在保持画面连续性的同时提高处理速度,都需要单独来解决。
从通用视频修复模型到视频去水印去字幕专用模型
市面上主流的视频修复模型有三种:
STTN(Spatial-Temporal Transformer Network)利用时空注意力,在视频的多个帧中寻找可供补全的内容,并联合处理输入帧。它提醒我们:修复视频不能只看单帧,前后帧可能包含当前被遮挡区域的有效信息。不过,当任务集中在面积较小的文字和图标时,仍需考虑通用时空建模带来的计算成本。1
E²FGVI(End-to-End Framework for Flow-Guided Video Inpainting)将光流补全、特征传播与内容生成放进可联合训练的框架。它利用帧间运动关系传递信息,为画面恢复提供了兼顾时序利用与效率的基础。原始 E²FGVI 处理的是给定 Mask 的视频修复任务,因此要用于自动去水印、去字幕,还需要改变模型获取区域信息的方式。2
ProPainter进一步改进了视频修复中的传播与 Transformer 部分:通过图像和特征两个域的传播寻找对应内容,并用 Mask 引导的稀疏视频 Transformer 完成修复。它展示了复杂场景下提升质量的一条路线,但具体任务中哪种方法更快、效果更好,仍应在相同分辨率、硬件和视频上测试,而不能只凭论文中的单项指标判断。3
这三种方法的主要任务是通用视频修复。去水印和去字幕则有更明确的对象:覆盖内容通常是文字、图标、Logo、描边和阴影,而不是形态任意的人或物体。从技术上来讲,只要能识别视频中的字幕和水印,将其使用蒙版遮挡起来,再利用上述的通用视频修复模型进行修复,即可实现无痕消除视频水印与字幕的目的。
水印与字幕有哪些可利用的特点
水印可能是固定在角落的半透明 Logo,也可能是跨画面的文字;字幕常出现在画面下方,但会随着台词变化,并带有不同的字体、描边、阴影或底色。这些元素变化很多,却仍比任意待移除物体更有规律。
透明覆盖是一个值得利用的线索。若某处叠加了半透明水印,原始背景的信息没有完全消失,而是与前景图案混合在一起。模型可以结合周围像素和相邻帧推断背景。对于不透明字幕或实心 Logo,当前帧提供的信息更少,前后帧的对应内容就更加重要。
这也说明,去除覆盖物不能简单等同于把字“抹掉”:理想结果还要保留人物、纹理和镜头运动,并让修复区域在连续播放时保持稳定。
基于 E²FGVI 的 Mask-free 设计
我们的目标是让模型接收带水印或字幕的视频,直接输出无水印无字幕的干净画面。Mask-free 指的是推理阶段无需用户提供 Mask,模型也不显式预测或输出 Mask。 它不意味着训练过程完全不使用覆盖区域的信息。
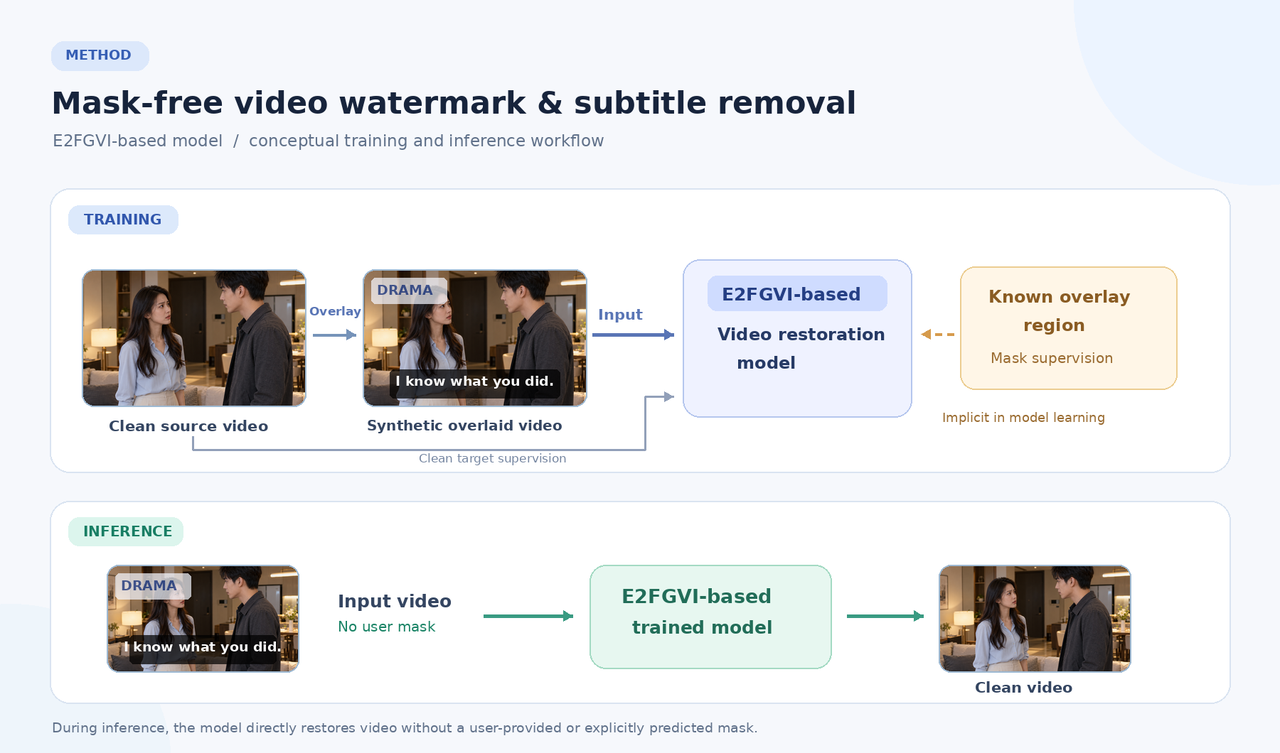
训练时,我们知道合成的水印和字幕被放在了哪里,因此可以利用这些已知区域对模型进行隐式监督。模型看到带覆盖的视频和对应的干净目标视频,学习识别受影响的内容,并借助跨帧信息恢复画面。区域信息参与训练,但实际处理新视频时,不再要求用户逐段框选,也不需要先运行一个显式的 Mask 预测步骤。
选择 E²FGVI 作为基础,是因为去除覆盖内容需要同时利用画面本身与帧间运动信息。我们的工作重点,则是让这个通用修复基础适应水印和字幕的形态,以及无需手动指定区域的使用方式。
用合成数据覆盖真实世界的变化
训练这类模型的一个实际问题是:很难为大量真实视频同时获得带水印版本和完全对应的无水印原片。合成数据提供了一种可控的办法。
我们采集大量图标与字体素材,在干净视频上合成 Logo、文字水印和字幕。合成时改变位置、大小、透明度、颜色、描边、阴影、底色与出现时间,也加入固定和移动的覆盖形式。这样既能得到带覆盖的输入,也保留了对应的干净目标,并且知道哪些区域受到了影响。
数据的多样性很关键。如果训练样本只包含底部白字,模型遇到半透明角标、花字字幕或复杂背景时就容易失效。因此,合成数据的作用不是重复同一种模板,而是尽量覆盖视频中常见的文字与图标形态。最终仍需要使用真实视频检查模型的泛化能力。
RTX 3090 上的推理耗时对比
我们在 RTX 3090 上以 1080p 视频测试推理耗时,并将结果按视频时长归一化。下表的 1:1 表示处理 1 分钟视频约需 1 分钟推理;1:5 表示处理 1 分钟视频约需 5 分钟推理。
| 方法 | 环境 | 视频时长 : 推理耗时长 | 处理 1 分钟视频约需时长 |
|---|---|---|---|
| E²FGVI | RTX 3090,1080p | 1:1 | 1 分钟 |
| STTN | RTX 3090,1080p | 1:1.5 | 1.5 分钟 |
| ProPainter | RTX 3090,1080p | 1:5 | 5 分钟 |
在这组测试中,本文方法处理 1080p 视频的推理耗时约等于视频时长;按上述比值计算,约为 STTN 的 1.5 倍速度、ProPainter 的 5 倍速度。这是本次环境下的实测对比,并不表示所有输入、硬件和实现都会得到相同比值。
对去水印、去字幕来说,速度也不只有模型推理一项。用户是否需要手动标注、视频解码与编码、长视频的处理方式,以及输出是否需要再次返工,都会影响最终体验。省去手动 Mask 步骤,减少的是操作成本;上表则展示模型推理时间的差异。
效果还需要与耗时一起检查。我们会关注覆盖内容残留、背景细节、帧间闪烁和原画面误改,并分别展示固定 Logo、半透明水印、普通字幕与动态花字。单个漂亮片段不足以代表所有场景。
结束语:局限性与改进方向
针对视频去水印与字幕这一更聚焦的任务,E²FGVI 模型,在推理时可以让模型直接处理视频,无需用户手动画 Mask,也无需显式预测 Mask,展现出了较好的消除效果和处理速度。
经过一段时间的线上运行实测,模型在3080ti/12G显存的卡即可稳定推理,推理成本在0.1/分钟左右,尤其适合要消除的水印或字幕样式简单,背景修复要求不是很高的场景,性价比非常突出。但仍然存在一些问题需要解决:
- 1视频修复效果在复杂背景下,仍然存在少量模糊;
- 2大面积不透明遮挡可能完全盖住关键背景;
- 3快速运动和镜头切换会减少可参考的相邻帧;
- 4贴近人物面部或细密纹理的字幕也更难恢复;
- 5遇到训练数据没有覆盖的特殊样式时,模型可能无法消除,或误改原本不该处理的画面。
上述问题,有些可以通过增加样本训练样式和数量来优化,比如,一些特殊样式的水印或者字幕无法消除等。但受限于通用修复模型本身的局限性,尤其是在复杂背景下的修复效果,轻微的模糊瑕疵不可避免,下面对比视频中 龙袍位置的修复,比较能看出效果差异性。
如果你的任务需要更加无痕的背景修复效果,支持消除更广泛或更复杂的水印及字幕样式,比如类似豆包的动态水印等,视频扩散(DiT)模型,会是更好的选择。欢迎使用和体验无痕AI ,一个基于视频扩散模型的在线视频去水印去字幕平台。平台不仅提供网页版工作台,同时提供视频去水印去字幕API,支持每账号最高100路并发,10分钟可完成接入并上线。
参考文献
- [1] Zeng et al., Learning Joint Spatial-Temporal Transformations for Video Inpainting, ECCV 2020.
- [2] Li et al., Towards An End-to-End Framework for Flow-Guided Video Inpainting, CVPR 2022.
- [3] Zhou et al., ProPainter: Improving Propagation and Transformer for Video Inpainting, ICCV 2023.